
Logiciel métier & ERP·
Outil métier : 5 signes qui l’imposent
5 signes concrets que vos outils freinent : Excel prolifère, doubles saisies, erreurs récurrentes, manque de visibilité et contournements.
15 min de lecture
Les données dispersées coûtent des milliers d'euros par an à la PME : erreurs, relances, doubles saisies, temps perdu et impact sur la marge.

Julien Thomas
Co-fondateur & CEO, Ziema
Je vais droit au but : des données éparpillées peuvent coûter entre 30 000 € et 60 000 € par an à une PME. Et ce coût ne vient pas d’un seul poste. Il se répartit entre erreurs de commande, retards de paiement, temps perdu, ressaisies, clôtures lentes et décisions prises sur de mauvais chiffres.
En clair, je retiens une idée simple : le sujet n’est pas seulement l’outil. Le sujet, c’est la marge, le cash et le temps d’équipe. Quand les fichiers, le CRM et la comptabilité ne parlent pas entre eux, chaque petit écart finit par coûter cher.
Voici ce que l’article montre, de façon directe :
Je note aussi un point utile : chaque poste peut se chiffrer en euros avec une formule simple. C’est ce qui permet d’estimer un retour sur investissement avant de lancer un projet.
| Coût caché | Ce que je regarde | Effet direct |
|---|---|---|
| Erreurs de commande | incidents, temps de correction, coût horaire | marge en baisse |
| Relances oubliées | factures en retard, jours perdus | cash bloqué |
| Temps de recherche | minutes/jour, effectif concerné | heures perdues |
| Doubles saisies | heures/mois, erreurs liées | charge en plus |
| Retards de clôture | jours de retard, coûts d’équipe | pilotage en retard |
| Mauvais chiffres | décisions revues, impact marge | mauvais arbitrages |
Mon résumé tient en une phrase : sans données centralisées, une PME paie tous les mois des coûts diffus, mais bien réels. La suite sert à les repérer, les estimer, puis les comparer au coût d’un projet de centralisation.
Dans une PME, des données dispersées finissent par produire plusieurs versions d’un même chiffre selon les équipes. Et ça, ce n’est pas un simple souci de confort : c’est un problème de fonctionnement au quotidien.
Au fond, cette dispersion génère trois types de coûts. D’abord, des écarts entre services. Ensuite, des délais de rapprochement. Enfin, une traçabilité trop faible pour corriger les erreurs sans perdre de temps. À chaque fois, l’impact est le même : du temps qui part, de la marge qui s’effrite, ou du cash qui reste bloqué.
Tant que les volumes restent modestes, beaucoup d’entreprises s’en sortent avec des fichiers, des exports et quelques ajustements manuels. Mais dès que l’activité prend de l’ampleur, ces bricolages pèsent lourd. Chaque relance, chaque clôture, chaque export devient une charge cachée.
Le plus piégeux, c’est que ce coût n’apparaît presque jamais dans une seule ligne. Il se diffuse dans toute l’exploitation, un peu partout à la fois.
Les six points suivants mettent des chiffres sur ces pertes.
Tarifs obsolètes, référence mal saisie, stock désynchronisé : la commande ne repose pas sur la même base selon l’outil consulté. Et c’est souvent là que les ennuis commencent. Une équipe voit un prix, une autre voit un stock différent, et la correction mange vite du temps.
Les signaux d’alerte sont assez faciles à repérer :
Pour chiffrer le ROI, partez de trois variables simples :
Le calcul de base est simple : (erreurs/an) × (temps de traitement × coût horaire). Puis ajoutez la marge perdue sur les retours, ainsi que les remises commerciales accordées pour rattraper le coup.
Avec une base de données unique, tout le monde travaille sur les mêmes tarifs, les mêmes fiches clients et les mêmes niveaux de stock. Concrètement, cela réduit les erreurs de préparation et d’expédition [1].
Le coût qui suit apparaît souvent dans les relances oubliées et les factures impayées.
Sans vue d’ensemble sur les échéances et les paiements, les relances partent trop tard. Résultat : le délai d’encaissement s’allonge, et chaque relance oubliée bloque du cash un peu plus longtemps.
Le signe ne trompe pas : l’équipe doit encore reconstituer à la main l’état des paiements pour savoir quels clients ont déjà été relancés et quelles factures sont toujours en attente.
Pour mettre un chiffre sur ce coût caché, suivez au minimum :
Le ROI du poste se calcule ainsi : factures en retard × jours de retard × montant moyen + temps mensuel de suivi manuel.
Quand les données sont centralisées, les relances partent au bon moment et l’historique reste visible. Le coût qui suit apparaît alors dans le temps perdu à chercher l’information entre plusieurs fichiers et outils.
Le coût le plus discret - et souvent l'un des plus lourds - , c'est le temps perdu à remettre la main sur une information.
Un commercial ouvre plusieurs outils. Un responsable opérations refait un tableau avant de répondre. Au fond, le problème est simple : des minutes s'envolent à chaque recherche.
Pourquoi ? À cause des allers-retours entre Excel, les e-mails, l'ERP et les dossiers partagés. Les équipes jonglent sans arrêt entre des outils qui ne communiquent pas bien entre eux. Faute de source unique, elles doivent recouper, vérifier, puis reconstituer l'information à la main. Résultat : des heures partent dans la recherche au lieu d'être consacrées au travail qui fait avancer l'équipe.
Pour mettre un chiffre sur ce coût, trois indicateurs suffisent :
La formule ROI est directe : temps de recherche × fréquence × collaborateurs × coût horaire.
Dès que les données sont centralisées, ces allers-retours tombent. L'information apparaît tout de suite, sans recoupement manuel. Comme le résume Julien Thomas, fondateur de Ziema : « Ce qui prenait des semaines se fait désormais en quelques secondes. » [1]
Et quand la donnée n'existe pas en un seul endroit, elle finit souvent par être ressaisie. C'est là qu'arrive le coût suivant : les doubles saisies.
Sans source unique, chaque équipe finit par ressaisir les mêmes infos. Une commande entrée dans un outil est recopiée dans Excel pour le suivi. Une fiche client mise à jour dans le CRM est ensuite retapée à la main dans un autre logiciel. À force, ce travail en double ralentit aussi les clôtures et rend les chiffres plus flous.
Les signes ne trompent pas :
Pour mettre un chiffre sur ce coût, la formule est simple : ROI = heures de saisie × coût horaire + coût des erreurs + abonnements inutiles.
Quand une seule source alimente tous les outils, la donnée circule automatiquement. Les ressaisies de tous les jours disparaissent. Et quand ces doublons s'empilent, la clôture mensuelle finit presque toujours par prendre du retard.
Après les doubles saisies, c’est souvent la clôture mensuelle qui paie l’addition. Quand la comptabilité, les ventes et la trésorerie vivent dans des fichiers séparés, avec des exports à répétition et de la ressaisie à la chaîne, tout devient plus lourd. Chacun attend les données des autres, consolide à la main, puis corrige les écarts. Au bout du compte, le reporting sort trop tard pour servir au pilotage.
Le coût le plus lourd, ce n’est pas juste un sujet d’organisation. C’est du temps humain bloqué sur des tâches qui n’apportent rien. Un DAF ou un contrôleur de gestion qui passe son temps à réconcilier des tableaux ne pilote plus l’activité. Il fait du copier-coller.
Les signes sont assez faciles à repérer :
Pour mettre un chiffre sur ce coût, regardez surtout trois points :
Quand la donnée est centralisée, le tableau de bord se met à jour en continu. La clôture n’est plus suspendue aux envois des uns et des autres : les chiffres sont déjà là, consolidés et fiables. Et quand le reporting arrive trop tard, le problème est simple : les décisions suivantes se prennent déjà avec des chiffres incomplets.
Une clôture tardive ne fait pas perdre du temps, point. Elle abîme aussi les décisions qui viennent juste après. Quand le reporting arrive trop tard, le souci ne s’arrête pas au retard : la décision suivante repose déjà sur une base fragile.
Le signe ne trompe pas : en réunion, on passe du temps à contester les chiffres au lieu de décider. Chacun arrive avec sa propre version. Et pendant que le débat s’éternise, les arbitrages commerciaux et budgétaires se dégradent.
Les effets sont très concrets. Une marge sous-estimée peut repousser un investissement. Une campagne peut continuer plus longtemps qu’il ne faut. Un produit peut rester en place alors que le besoin n’a pas été validé.
Le coût d’une décision faussée n’apparaît pas toujours tout de suite dans une ligne comptable. Pourtant, il finit vite par peser sur la marge. Pour le mesurer, regardez des points simples :
Quand la donnée est centralisée et mise à jour en continu, tout le monde travaille enfin avec une seule version des chiffres, au même moment. Et là, l’effet sur le ROI devient clair : moins d’arbitrages retardés, moins d’erreurs de pilotage, plus de marge sécurisée. Ces pertes peuvent ensuite se convertir en ROI, poste par poste.
Additionnez ces six coûts pour obtenir votre base annuelle de calcul. L’idée est simple : mettre chaque perte en euros avec une formule claire, puis comparer la situation avant et après centralisation.
| Coût caché | Donnée d'entrée | Formule annuelle (avant) |
|---|---|---|
| Erreurs de commande | Incidents/mois × coût moyen de correction | (Incidents × coût moyen de correction) × 12 |
| Relances et factures impayées | Factures en retard | (Factures en retard × montant moyen × jours de retard) + coût des relances |
| Temps de recherche | Heures perdues/semaine | Heures perdues × coût horaire chargé × 52 |
| Doubles saisies | Heures perdues/mois | Heures perdues × coût horaire chargé × 12 |
| Retards de clôture | Jours-homme de clôture par mois | Jours-homme × coût journalier chargé × 12 |
| Décisions fondées sur des chiffres incomplets | % d'écart de marge | CA annuel × taux de marge moyen × % d'écart de marge |
Ensuite, calculez le coût après centralisation en gardant un coût résiduel pour les cas limites. En clair, il ne faut pas partir du principe que tout disparaît du jour au lendemain. Il reste souvent un peu de friction : quelques erreurs, un peu de reprise manuelle, ou des retards ponctuels.
Le calcul devient alors très direct :
Ce total sert ensuite à estimer le ROI annuel d’une PME française.
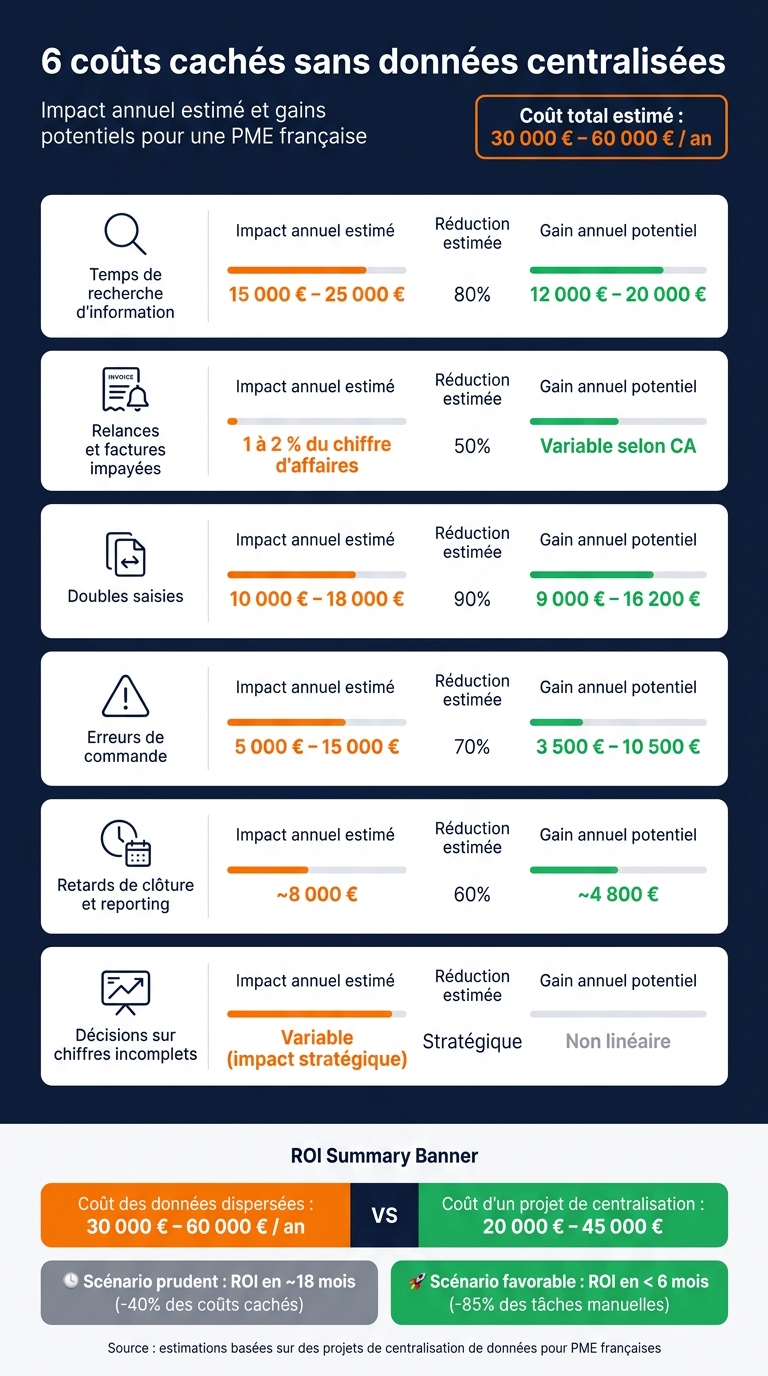
6 coûts cachés des données non centralisées : impact et gains pour une PME
À partir du calcul précédent, on peut dégager un ordre de grandeur assez parlant pour une PME française qui jongle encore avec des données dispersées et beaucoup de saisies manuelles. Le tableau ci-dessous traduit chaque coût caché en gain annuel potentiel, sur la base d'ordres de grandeur observés sur des projets de centralisation de données pour PME [1].
| Coût caché | Impact annuel estimé (€) | Données à collecter | Réduction estimée | Gain annuel (€) |
|---|---|---|---|---|
| Temps de recherche | 15 000 – 25 000 | Minutes perdues par jour × effectif × coût horaire chargé | 80 % | 12 000 – 20 000 |
| Relances et factures impayées | 1 à 2 % du chiffre d'affaires | DSO, créances douteuses, factures non relancées à temps | 50 % | Non chiffrable directement |
| Doubles saisies | 10 000 – 18 000 | Heures de ressaisie entre CRM, ERP et Excel | 90 % | 9 000 – 16 200 |
| Erreurs de commande | 5 000 – 15 000 | Coût des retours, avoirs et réexpéditions | 70 % | 3 500 – 10 500 |
| Retards de clôture et reporting | ~8 000 | Jours-homme de clôture et consolidation mensuelle | 60 % | ~4 800 |
| Décisions sur chiffres incomplets | Variable | Surstocks, sous-stocks, ventes manquées - impact stratégique, non linéaire selon le secteur et les marges | Stratégique | Non linéaire |
En pratique, le gain annuel total se situe souvent entre 30 000 € et 60 000 € pour un projet de centralisation bien cadré. En face, le coût d'un projet de centralisation ou d'une application métier sur mesure pour une PME française tourne le plus souvent entre 20 000 € et 45 000 €, selon le périmètre retenu [1].
Sur le terrain, deux scénarios reviennent souvent. Dans une approche prudente - avec une baisse de 40 % des coûts cachés et un déploiement progressif - le retour sur investissement se situe autour de 18 mois [1]. À l'inverse, dans un scénario plus favorable - avec 85 % de baisse des tâches manuelles - le seuil de rentabilité peut tomber à moins de 6 mois [1].
Une fois le ROI posé noir sur blanc, le constat est direct : ces six coûts cachés ne se voient pas toujours dans le compte de résultat, mais ils rognent la marge, mois après mois. Le vrai sujet n’est pas le prix d’un projet de centralisation. C’est le prix de l’inaction.
Centraliser les données, ce n’est pas juste un chantier informatique. C’est un levier de rentabilité. Le plus simple, en pratique, consiste à chiffrer d’abord le poste qui coûte le plus cher, puis à comparer l’avant et l’après. Le code n’est qu’un outil. L’enjeu, c’est la marge et le cash. Et quand Excel ou un logiciel standard atteint ses limites, choisir entre logiciel sur mesure ou SaaS devient souvent le chemin le plus court vers le ROI.
Commencez par repérer les frictions du quotidien que vous pouvez mesurer dans vos processus métiers.
Par exemple :
Le but est simple : mettre un chiffre sur un problème qui revient souvent afin d’en estimer le coût réel.
Quand on fait cet exercice, on passe d’un ressenti flou à un sujet concret. Et là, la discussion change : on ne parle plus d’une gêne au jour le jour, mais d’un manque à gagner, d’heures perdues ou de retards qui pèsent sur l’activité.
Pour calculer le ROI de la centralisation des données, suivez deux choses de près : les gains de productivité et la baisse des coûts opérationnels liés à l’automatisation.
Concrètement, l’idée est simple. Si vos équipes passent moins de temps sur des tâches manuelles, vous récupérez des heures de travail. Et si vous limitez les erreurs et les tâches répétitives, vous réduisez aussi des coûts qui, mis bout à bout, pèsent lourd.
Voici les indicateurs à suivre :
C’est souvent là que tout se joue. Une donnée centralisée ne sert pas seulement à mieux ranger l’information. Elle évite aussi les allers-retours, les doublons et les petites erreurs du quotidien qui finissent par coûter cher.
Elle devient rentable à partir du moment où les coûts cachés liés à des données éparpillées dépassent le coût de mise en place.
En clair, il faut repérer ce point de bascule avec le ROI. L’idée est simple : chiffrer l’avant et l’après centralisation, puis comparer. Il faut donc mesurer des éléments très concrets, comme les erreurs de commande, les oublis de relance, le temps perdu à chercher une information, les doublons, les retards de clôture et les décisions prises sur la base de mauvais chiffres.
Écrit par
Co-fondateur & CEO de Ziema
Je dirige Ziema, où nous concevons les logiciels métier que les éditeurs du marché ne font pas : applications métier, plateformes opérationnelles et SaaS verticaux. Au forfait, avec un périmètre et un délai engagés. Nos références : 24 Heures Le Mans, E.Leclerc, Théra-Connect.
Suivre sur LinkedInOn développe l'application métier calquée sur votre activité, celle qui vous fait gagner le plus de temps. Le code vous appartient.
Une question sur votre projet ?
Décrivez-le en deux lignes, on vous répond sous 24h.
Logiciel métier & ERP·
5 signes concrets que vos outils freinent : Excel prolifère, doubles saisies, erreurs récurrentes, manque de visibilité et contournements.
15 min de lecture

IA & automatisation·
Priorisez le process, pas l'outil : comparatif de 12 solutions pour automatiser les flux, protéger les données et gérer la facturation.
22 min de lecture
Budget & méthode·
Un logiciel métier sur mesure pour PME coûte 3 000 € à 150 000 € : intégrations, sécurité et maintenance font vite grimper la note.
12 min de lecture