IA & automatisation·
IA en entreprise : démarrer par un pilote
Pilotez l’IA sur 30 jours : testez une tâche répétitive, mesurez temps gagné, risques et ROI pour choisir l’outil adapté.
11 min de lecture
Limitez accès, hébergement, tests et relecture humaine pour déployer une IA générative métier en toute sécurité.

Julien Thomas
Co-fondateur & CEO, Ziema
Pour sécuriser une IA générative dans un logiciel métier, je commence par limiter ses accès et bloquer toute action sensible sans accord humain. Avant de développer, je fixe un usage précis, un responsable et les données strictement utiles.
Voici les 5 points que je vérifie :
Mon repère : <u>si les accès ne sont pas maîtrisés, je ne déploie pas</u>. En cas de fuite ou d’action sensible sans accord, j’arrête l’IA et je reviens au traitement manuel.
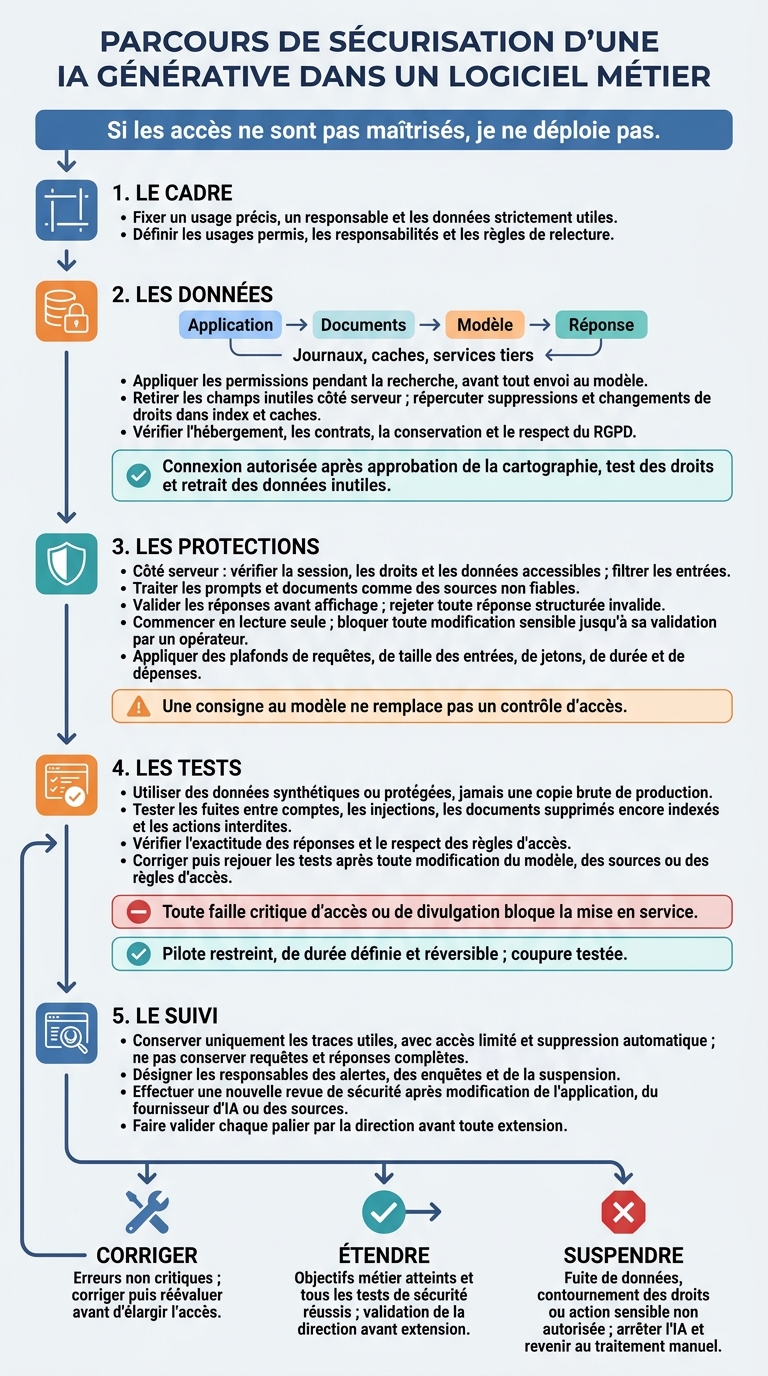
Sécuriser une IA générative : les 5 étapes clés
Après avoir cadré les usages, cartographiez le parcours application → documents → modèle → réponse. Incluez les journaux, les caches et les services tiers connectés pour éviter toute exposition imprévue. Pour chaque destination, précisez les champs transmis, leur utilité, le lieu de traitement, les personnes qui peuvent y accéder et la durée de conservation, copies temporaires comprises.
Avant de connecter les sources, définissez une matrice d’accès. Les droits doivent dépendre du rôle et du niveau de confidentialité, jamais du seul profil technique.
| Catégorie de données | Décision d’accès |
|---|---|
| Documents internes autorisés | Autoriser les extraits nécessaires, dans la limite des droits existants |
| Données personnelles nécessaires | Masquer les champs inutiles et pseudonymiser si possible |
| Données sensibles et commentaires libres | Exclure par défaut, sauf besoin précisément justifié |
Appliquez les permissions pendant la recherche, avant tout envoi au modèle. Masquer une réponse après sa génération ne suffit pas.
Répercutez les changements de droits et les suppressions dans les index et les caches : aucune ancienne copie ne doit rester consultable. Aucun champ inutile ne doit quitter la source. Retirez ces champs côté serveur, pas seulement dans l’interface. La pseudonymisation, elle, ne rend pas les données anonymes.
Une fois les données autorisées définies, comparez les lieux d’hébergement et les engagements contractuels.
Une API externe peut aussi être hébergée en Europe : ces catégories ne s’excluent pas. L’hébergement seul ne garantit ni la sécurité ni la conformité. Les droits, les flux et le contrat comptent aussi.
| Point de contrôle | Modèle local ou auto-hébergé | Modèle managé hébergé en Europe | API externe |
|---|---|---|---|
| Exposition des données | Maîtriser les flux sortants, télémétrie comprise | Contrôler les flux hors de l’hébergement prévu | Limiter les données transmises au service |
| Administration | Maintenir l’infrastructure, les correctifs et les dépendances | Définir le partage des tâches de sécurité | Sécuriser l’intégration au service |
Avant l’intégration, faites valider ces contrôles sur les sources, les journaux et les clauses du prestataire. N’autorisez la connexion qu’une fois la cartographie des sources approuvée, les droits testés et les données inutiles retirées.
Vérifiez les durées de conservation, la réutilisation pour l’entraînement, les sous-traitants, les transferts hors EEE et les accès du support. Pour les données personnelles, contrôlez aussi les engagements prévus par l’article 28 du RGPD et les garanties encadrant les éventuels transferts.
Après avoir défini les données autorisées, sécurisez le parcours de chaque requête et les actions qu’elle peut déclencher. Le serveur vérifie la session, les droits et les données accessibles, filtre les entrées, puis appelle le modèle. L’application valide ensuite la réponse avant de l’afficher. Aucune vérification ne doit reposer sur une consigne envoyée au modèle. Le contenu injecté dans la requête présente lui aussi un risque.
Une injection de prompt peut se cacher dans une demande ou un document pour détourner le modèle. Gardez les règles de l’application séparées du contenu utilisateur et des extraits récupérés. Limitez l’accès aux sources autorisées : un document ne peut ni accorder un droit ni approuver une action. Seul le serveur fait autorité.
Le filtrage des entrées ne suffit pas : contrôlez aussi les réponses et les actions permises. Pour une réponse structurée, vérifiez les champs attendus, leurs types et les valeurs autorisées. Rejetez toute réponse invalide.
Commencez en lecture seule. Par la suite, toute écriture doit passer par un outil dédié, explicitement autorisé et limité à une seule opération. Toute modification sensible reste bloquée jusqu’à sa validation par un opérateur.
Fixez des plafonds pour le nombre de requêtes, la taille des entrées, les jetons, la durée et les dépenses. Faites appliquer ces limites côté serveur. Pour chaque échec, affichez un message distinct et basculez vers le traitement manuel. Avant le pilote, vérifiez que les écritures restent bloquées tant qu’elles ne sont pas validées.
Une fois les accès définis, vérifiez l’isolement des données dans un environnement de test, avant toute mise en service.
Préparez des tests que vous pourrez rejouer avec des données synthétiques ou protégées, jamais avec une copie brute de production. Pour chaque test, consignez le compte utilisé, ses droits, la requête et le résultat attendu. Relancez ces tests après chaque modification du modèle, des sources ou des règles d’accès.
Contrôlez les accès entre utilisateurs, services et applications clientes. Testez les champs confidentiels, les documents supprimés mais encore indexés, les instructions cachées dans les documents et les actions interdites.
Pour chaque réponse, vérifiez deux points : l’exactitude du contenu et le respect des règles d’accès.
Regroupez les résultats dans un registre commun. Distinguez bien le comportement observé du comportement attendu.
| Scénario | Comportement attendu | Comportement observé | Décision |
|---|---|---|---|
| Accès avec le compte B aux données privées du compte A | Aucun contenu divulgué | À consigner | Corriger et retester |
| Instruction malveillante dans un document | Instruction ignorée, aucun accès supplémentaire | À consigner | Corriger et retester |
| Recherche d’un document supprimé | Aucune présence dans les résultats ni dans la réponse | À consigner | Corriger et retester |
| Demande d’export avec un rôle en lecture seule | Export refusé | À consigner | Corriger et retester |
Suivez également la qualité des réponses, la latence et le besoin de relecture. Définissez les seuils d’acceptation avant les essais et désignez nommément la personne qui autorise le pilote.
Toute faille critique d’accès ou de divulgation bloque la mise en service jusqu’à sa correction et à la réussite des nouveaux tests.
Si les tests d’isolement sont conformes, lancez un pilote réversible sur un périmètre restreint, pour une durée définie.
Nommez la personne responsable de l’arrêt et testez la coupure : elle doit désactiver l’IA sans perte de données ni interruption du travail courant. Une fuite, un contournement des droits ou une action sensible non approuvée impose l’arrêt.
Après le pilote, suivez les usages réels. N’élargissez l’accès qu’une fois chaque palier validé.
Ne conservez pas les requêtes et les réponses complètes. Gardez uniquement les identifiants utiles, les versions du modèle et des règles, les sources consultées, les validations, les erreurs et les incidents de sécurité. Définissez une durée de conservation et une suppression automatique. Réservez l’accès aux personnes habilitées.
Ces traces permettent aussi de qualifier les incidents et de décider s’il faut arrêter le service. Désignez les responsables des alertes, des enquêtes et de la suspension. Toute modification de l’application, du fournisseur d’IA ou des sources de données doit faire l’objet d’une nouvelle revue de sécurité avant déploiement.
Avant chaque extension, vérifiez que la finalité reste la même, que seules les données nécessaires sont accessibles, que les garde-fous fonctionnent et que la relecture humaine a bien lieu.
Appuyez-vous sur cette grille pour décider de la suite.
| Décision | Condition d’application |
|---|---|
| Étendre | Les objectifs métier sont atteints et tous les tests de sécurité sont passés avec succès. |
| Corriger | Des erreurs non critiques ont été repérées. Corrigez-les, puis réévaluez les résultats avant d’élargir l’accès. |
| Suspendre | Une fuite de données, un contournement des droits d’accès ou une action sensible non autorisée a eu lieu. |
Si les résultats restent conformes, soumettez le palier à la direction pour validation.
Pour chaque palier, présentez à la direction un dossier court précisant la finalité, les usages autorisés, les données visibles, la journalisation, les règles de relecture et les responsabilités. La direction doit valider ce palier avant toute extension de l’accès.
Assurez-vous que votre contrat de sous-traitance interdit explicitement au prestataire de réutiliser vos données pour entraîner ses modèles sans votre accord explicite [1].
Le cadre du projet doit aussi définir les règles de sécurité, les accès autorisés et les modalités de conservation des données [1]. Pour protéger vos informations sensibles, privilégiez un hébergement européen ou une solution souveraine [2][3].
Toute action sensible doit être validée par une personne : changement de RIB, validation de paiement, engagement juridique ou export vers la comptabilité. Ce contrôle vise à éviter les fraudes, les erreurs et les engagements non autorisés.
La vérification humaine doit aussi être systématique pour les contenus générés ou extraits, en particulier ceux à haut risque. Elle concerne également les documents ambigus, les champs signalés comme incertains, les réponses destinées à des interlocuteurs externes et les décisions sensibles qui impliquent des données confidentielles.
Une analyse d’impact relative à la protection des données (AIPD) est nécessaire si l’assistant traite des données sensibles ou présente des risques élevés pour les personnes, notamment lorsque le traitement se fait à grande échelle ou de façon systématique.
Formalisez cette analyse dès le cadrage, avant le démarrage. Si un risque élevé persiste malgré les mesures prévues, vous devez consulter la CNIL avant tout traitement. Un DPO interne n’est pas indispensable, mais son accompagnement reste vivement recommandé.
Écrit par
Co-fondateur & CEO de Ziema
Je dirige Ziema, où nous concevons les logiciels métier que les éditeurs du marché ne font pas : applications métier, plateformes opérationnelles et SaaS verticaux. Au forfait, avec un périmètre et un délai engagés. Nos références : 24 Heures Le Mans, E.Leclerc, Théra-Connect.
Suivre sur LinkedInOn développe l'application métier calquée sur votre activité, celle qui vous fait gagner le plus de temps. Le code vous appartient.
Une question sur votre projet ?
Décrivez-le en deux lignes, on vous répond sous 24h.
IA & automatisation·
Pilotez l’IA sur 30 jours : testez une tâche répétitive, mesurez temps gagné, risques et ROI pour choisir l’outil adapté.
11 min de lecture
Budget & méthode·
Règles pratiques pour minimiser, archiver et purger les données selon le RGPD : finalités par champ, durées, logs et droits d'accès.
10 min de lecture
IA & automatisation·
Automatiser la saisie administrative en PME : extraction, contrôles humains, sécurité des données et pilote limité.
7 min de lecture