Logiciel métier & ERP·
Bascule ERP pour PME — 7 étapes clés
7 étapes pratiques pour réussir la bascule ERP en PME : périmètre restreint, migrations répétées, tests métier, runbook et hypercare.
12 min de lecture
Séparez ressources et bloquez échanges inutiles : 6 pratiques pour limiter la propagation d’attaques dans votre cloud.

Julien Thomas
Co-fondateur & CEO, Ziema
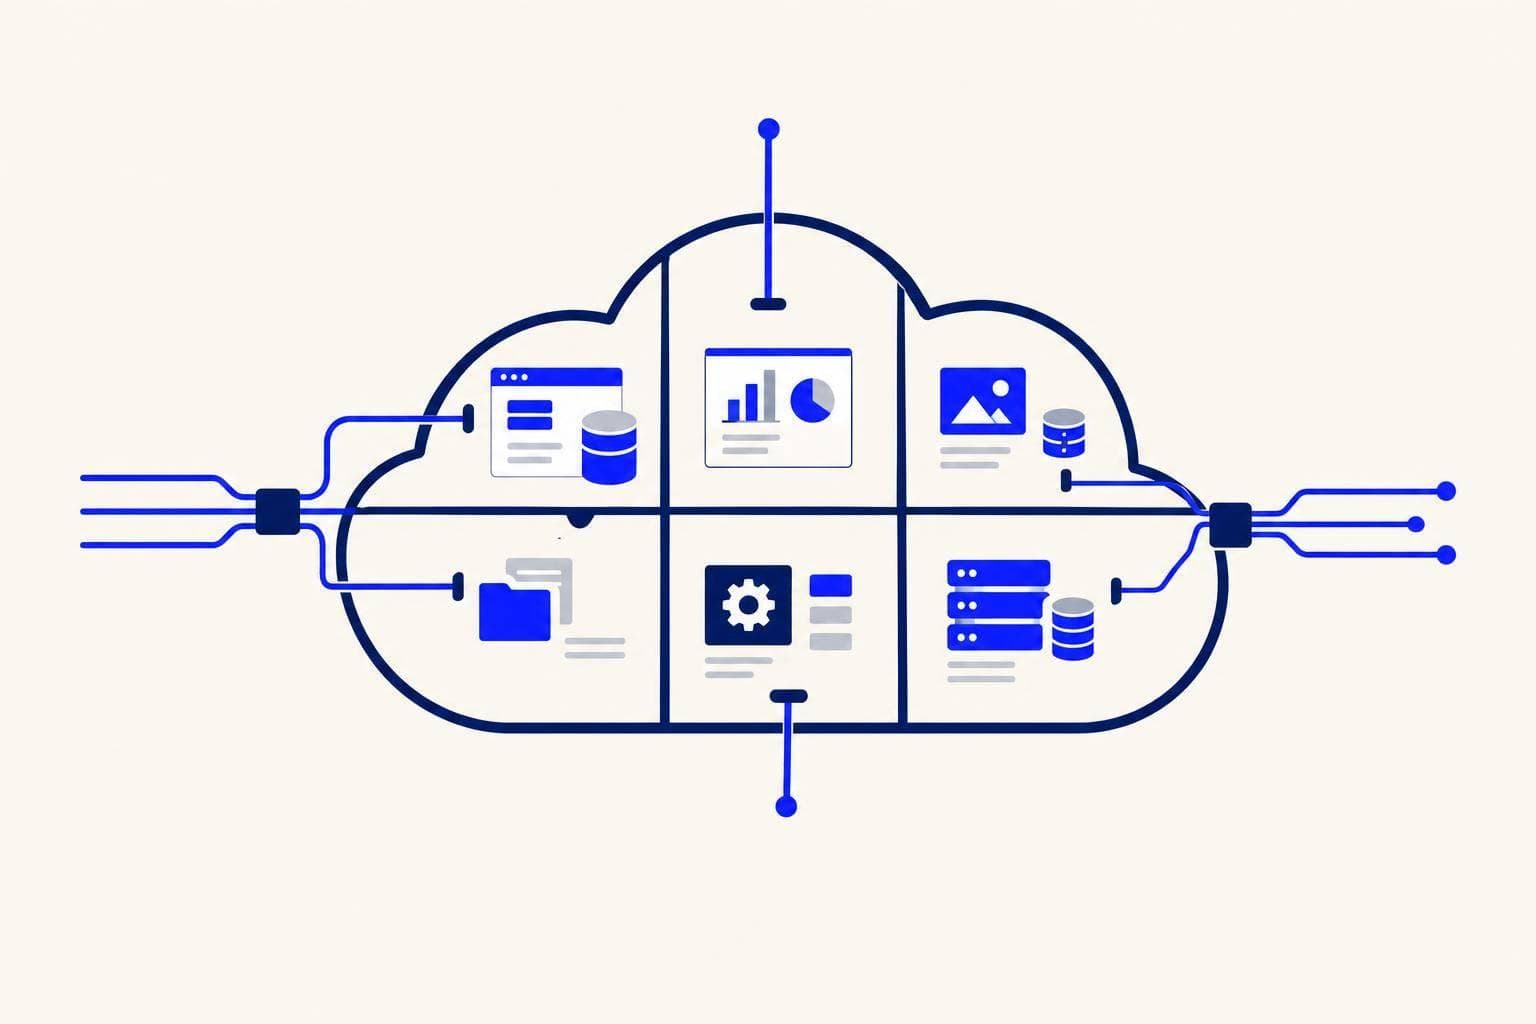
Pour limiter la propagation d’une attaque dans votre cloud, je recommande de séparer les ressources et de bloquer les échanges inutiles. Je commence par recenser les actifs et leurs flux, puis je protège en priorité l’administration, les données sensibles et les sauvegardes.
Voici les 6 pratiques que je retiens :
Mon point de contrôle : <u>tester les échanges permis, mais aussi les blocages attendus</u>. Je déploie d’abord sur un périmètre limité, avec un retour arrière prêt à exécuter. La segmentation réduit les risques ; elle ne remplace ni les correctifs, ni les sauvegardes, ni la vérification des identités.
Commencez par recenser les applications, machines virtuelles, conteneurs, bases de données, espaces de stockage et connexions externes. Pour chaque ressource, précisez sa fonction métier, son environnement, son exposition à Internet, son propriétaire métier et son responsable technique. Séparez la sensibilité des données de la criticité métier : des données peuvent être publiques, internes ou confidentielles ; la criticité dépend, elle, des conséquences d’une indisponibilité.[6][7] Cette cartographie permet de tracer des frontières réalistes entre les zones.
Documentez ensuite chaque échange dans une matrice de flux. Indiquez la source, la destination, le service, le port, le protocole, le sens, la fréquence, la méthode d’authentification, les données échangées et la justification métier. Précisez aussi le propriétaire métier et le responsable technique du flux, puis attribuez-lui un statut : nécessaire, exceptionnel, obsolète ou à vérifier.
Une mention vague comme « accès entre serveurs » ne suffit pas pour écrire une règle.
Distinguez les flux qui franchissent la frontière externe du cloud, dits nord-sud, de ceux qui relient ses ressources internes, dits est-ouest. L’analyse ne doit pas se limiter aux accès Internet : après une première intrusion, un attaquant peut utiliser les échanges internes pour progresser.[4][5][8]
Pensez aussi aux dépendances moins visibles : DNS, identité, horodatage, certificats, supervision, mises à jour et secrets. Documentez les accès d’administration, les sauvegardes et les liens de reprise, en précisant leurs horaires et leurs destinations. Un oubli peut interrompre l’authentification, la surveillance ou une restauration après le cloisonnement.[1]
Comparez la matrice aux journaux des pare-feu, des passerelles cloud et des répartiteurs de charge. Choisissez une période d’observation qui couvre les traitements de fin de mois, les sauvegardes et les opérations de maintenance. Un flux observé n’est pas forcément légitime : faites valider chaque échange inconnu avant de l’autoriser ou de le bloquer.[6] Utilisez cette base pour ne laisser passer que les connexions strictement utiles.
Le moindre privilège vaut aussi pour le réseau : chaque service, utilisateur et administrateur accède uniquement aux ressources dont il a besoin.
Partez de la matrice de flux pour traduire chaque échange validé en une autorisation précise : source, destination, port et protocole. Traitez séparément les connexions entrantes et sortantes. Autoriser un service à recevoir une connexion ne lui donne pas le droit d’en ouvrir une ailleurs.
Privilégiez une liaison ciblée entre deux services plutôt qu’une ouverture générale entre réseaux. Une interconnexion ne doit pas permettre tous les échanges.
Après avoir validé les dépendances, appliquez le refus par défaut : groupes de sécurité sur les ressources, ACL réseau sur les sous-réseaux et règles de pare-feu entre les zones. Avec une ACL sans état, autorisez explicitement le trafic de retour et les ports éphémères. [12]
Activez les journaux, puis vérifiez les deux résultats attendus : les opérations métier fonctionnent et les connexions non autorisées échouent, y compris les connexions sortantes. [10]
Donnez aux salariés accès aux seules applications utiles à leur rôle, sans accès direct aux bases de données. Pour l’administration, imposez un VPN ou un bastion, des comptes dédiés, une authentification multifacteur et des droits limités. N’exposez jamais SSH ni RDP directement à Internet.
Avant d’activer le blocage, utilisez le mode observation s’il existe et faites tester les parcours métier par les utilisateurs concernés. [2][11] Ces règles préparent le découpage en zones, détaillé dans la section suivante.
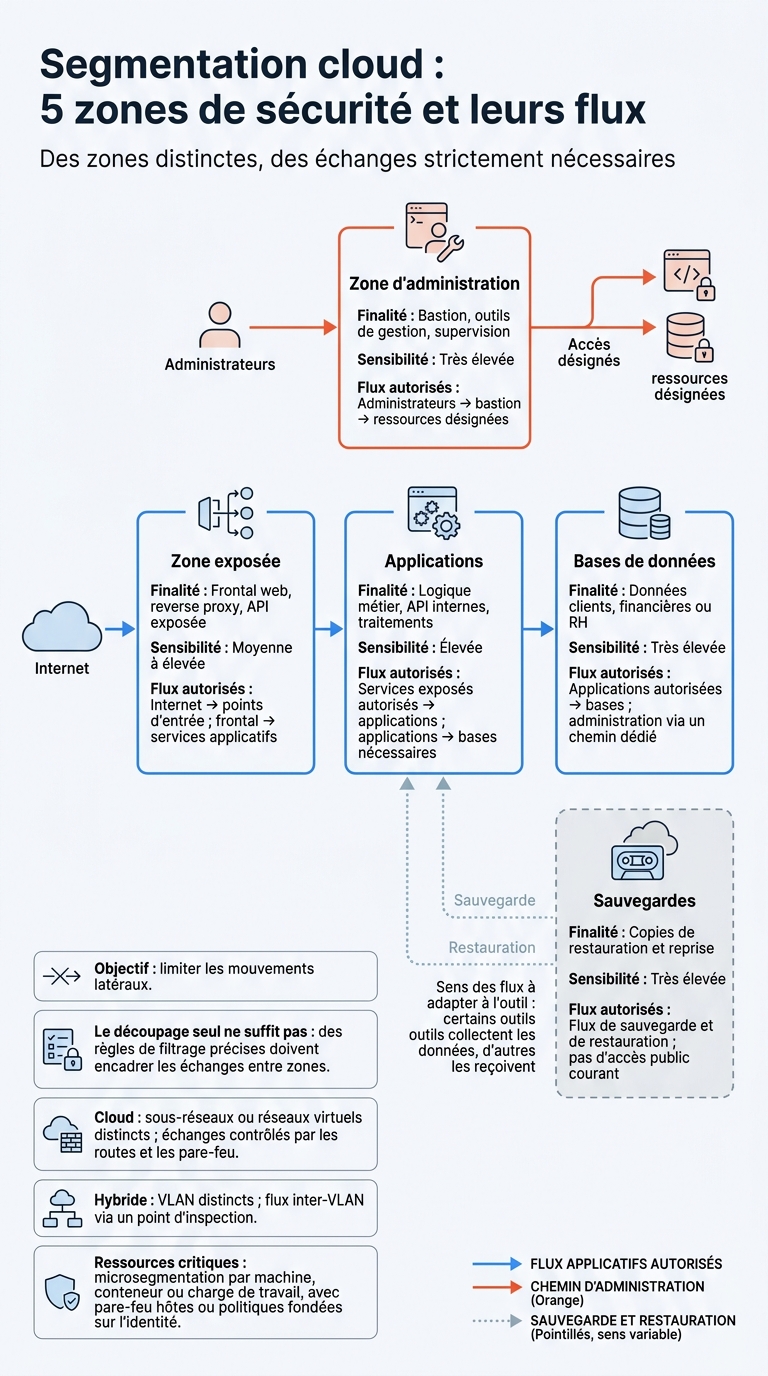
Segmentation cloud : 5 zones de sécurité et leurs flux
Regroupez les ressources selon leur fonction, leur sensibilité et leurs besoins d’échange. Le but : limiter les mouvements latéraux en transformant la cartographie des actifs en frontières concrètes dans le réseau. [1]
| Zone | Finalité | Sensibilité | Flux autorisés |
|---|---|---|---|
| Zone exposée | Frontal web, reverse proxy, API exposée | Moyenne à élevée | Internet → points d’entrée ; frontal → services applicatifs |
| Applications | Logique métier, API internes, traitements | Élevée | Services exposés autorisés → applications ; applications → bases nécessaires |
| Bases de données | Données clients, financières ou RH | Très élevée | Applications autorisées → bases ; administration via un chemin dédié |
| Zone d’administration | Bastion, outils de gestion, supervision | Très élevée | Administrateurs → bastion → ressources désignées |
| Sauvegardes | Copies de restauration et reprise | Très élevée | Flux de sauvegarde et de restauration ; pas d’accès public courant |
Ajustez ces chemins à votre outil de sauvegarde : certains outils collectent les données, d’autres les reçoivent. [8][14] Le découpage seul ne suffit pas : des règles de filtrage précises doivent encadrer les échanges entre zones.
Dans le cloud, placez les zones dans des sous-réseaux ou des réseaux virtuels distincts. Contrôlez ensuite leurs échanges avec les routes et les pare-feu. En hybride, séparez aussi les réseaux locaux en VLAN et faites passer les flux inter-VLAN par un point d’inspection. [13][14]
Pour les actifs les plus sensibles, allez plus loin : appliquez le cloisonnement à chaque charge de travail.
La microsegmentation applique les règles à chaque machine, conteneur ou charge de travail. Elle s’appuie sur des pare-feu hôtes ou sur des politiques fondées sur l’identité. [3][13][15]
Cas hypothétique : une entreprise française de logistique de 60 salariés. Son portail client rejoint uniquement l’API en HTTPS ; l’API accède à la base par un port privé dédié. Le système d’entrepôt local échange seulement les messages nécessaires via un VPN contrôlé. Les sauvegardes immuables restent dans un compte ou réseau séparé. Ce découpage permet de conserver les échanges métier sans ouvrir tout le réseau de l’entrepôt au portail. [13][14][16]
Une fois les zones en place, il faut filtrer et observer les flux entre elles.
Appliquez le refus par défaut, en entrée comme en sortie. En entrée, ouvrez uniquement les services publics nécessaires, comme HTTPS sur le port 443. En sortie, autorisez seulement les destinations liées aux dépendances documentées : résolveurs DNS autorisés, serveurs de mise à jour et services SaaS validés.
Pour chaque règle, indiquez la source, la destination, le protocole, le port, le sens du trafic, la justification métier et le responsable du flux. [17][18]
Déclinez ensuite ces règles à chaque niveau de contrôle : ressource, sous-réseau ou application.
Dans votre cloud, associez les groupes de sécurité, pour régler les accès à chaque ressource, aux ACL réseau, pour bloquer les flux au niveau du sous-réseau. [22][23]
Vérifiez aussi les chemins empruntés : aucune route ne doit permettre de contourner les points de filtrage.
Faites passer les flux sortants des ressources privées par un point contrôlé et limitez les échanges entre zones.
Si la plateforme le permet, ajoutez un filtrage des domaines ou des URL autorisés pour les appels à une API externe. Pour un service HTTP public, placez un pare-feu applicatif web (WAF) devant le service. [17][21][24]
Le filtrage bloque les écarts ; la surveillance détecte les flux anormaux entre zones. Centralisez les journaux des flux acceptés et refusés en conservant l’horodatage, la source, la destination, les ports, le protocole et la décision. Protégez ces journaux et définissez une durée de conservation adaptée à vos besoins.
Ciblez d’abord les alertes sur les nouveaux échanges internes, les accès administratifs inattendus et les flux entre production et développement. Désignez un responsable pour chaque alerte et testez son déclenchement. [19][20]
Après avoir filtré les flux, placez les données les plus sensibles dans un périmètre séparé.
Installez les bases de données dans un sous-réseau privé, sans accès direct à Internet. Si vous utilisez un service managé, configurez un point de terminaison privé et désactivez l’accès public. Les utilisateurs doivent passer par l’application, jamais accéder directement à la base.
Ce cloisonnement complète le chiffrement, les correctifs et l’authentification forte : il ne les remplace pas. [29]
Limitez l’accès applicatif aux seuls services autorisés. Pour administrer la base, imposez un chemin d’administration distinct, avec des comptes nominatifs et des droits temporaires. Le compte applicatif ne doit jamais disposer de droits d’administration sur la base. [28]
Appliquez aussi cette séparation aux sauvegardes et aux restaurations.
Dédiez une identité de service et des règles d’accès aux sauvegardes. Gardez une copie chiffrée et isolée, que le compte applicatif ne peut ni modifier ni supprimer.
N’autorisez la restauration que par un chemin approuvé. Testez-la régulièrement sur une cible isolée et mesurez les délais de restauration. [29]
La segmentation ne suffit pas à assurer la conformité au RGPD. Elle fait toutefois partie des mesures de sécurité proportionnées au risque prévues par l’article 32. [25][26]
Archivez le schéma, les droits et les tests de restauration pour prouver le maintien des protections. [27]
Après avoir isolé les données, segmentez aussi les réseaux des environnements qui les utilisent.
Placez la production et le hors production dans deux comptes ou abonnements cloud distincts. Séparez également le développement des tests si les risques le justifient. Cloisonnez chaque environnement par le réseau et les règles d’accès. N’autorisez une liaison entre eux que si elle répond à un besoin documenté.
Utilisez des secrets, des clés et des identités de service propres à chaque environnement. Aucun identifiant de production ne doit servir en test. Les développeurs ne disposent pas de droits permanents en production : leurs interventions nécessitent des droits nominatifs temporaires et une authentification multifacteur.
La chaîne de déploiement doit respecter ces mêmes frontières.
Soumettez le code et les définitions d’infrastructure à une revue et à des tests automatisés. Déployez ensuite le même artefact validé, sans le reconstruire, avec approbation et journalisation.
Placez les agents CI/CD dans une zone dédiée et segmentez les agents de compilation, de test et de déploiement. Attribuez-leur des identités distinctes pour chaque tâche, sans accès général aux bases de production. Testez le retour arrière avant la mise en service.
Un environnement de test ne doit jamais devenir un point d’entrée vers la production. Bloquez par défaut les accès du développement et des tests aux bases, stockages, files de messages et journaux de production. Fournissez plutôt des données synthétiques ou des extraits anonymisés, limités aux données nécessaires.
Les services de test doivent utiliser leurs propres dépendances. Fixez une durée de vie aux environnements temporaires et automatisez leur suppression. Vérifiez aussi qu’une identité de test ne peut ni lire le stockage de production ni utiliser ses secrets.
Revoyez ces cloisonnements dès qu’un déploiement, un flux ou un droit change, pour que les règles suivent les modifications.
La segmentation s’entretient dans la durée : chaque règle doit rester justifiée, testée et à jour.
Une fois les zones, les flux et les environnements définis, gardez les règles en accord avec ces choix et la cartographie. Attribuez à chacune un responsable technique et un responsable métier.
Documentez sa justification, les sources, les destinations, les ports autorisés, l’environnement, les dates de création et d’expiration, ainsi que la référence du changement. Examinez en priorité toute règle sans responsable ou sans besoin métier actuel.[30]
Prévoyez une suppression automatique à échéance, pas seulement un rappel. Chaque demande doit indiquer le motif, l’approbateur, les ressources concernées, les ports autorisés et les heures de début et de fin.
Toute prolongation exige une nouvelle validation. Vérifiez chaque mois les nouvelles règles et celles qui arrivent à échéance.[30]
Avant de supprimer une règle, vérifiez l’usage réel de chaque flux. Comparez la configuration aux journaux pour repérer les règles inutilisées, redondantes ou trop larges.
L’absence de trafic ne suffit pas : confirmez avec le responsable applicatif les besoins liés aux sauvegardes, à la supervision et aux traitements de clôture. Prenez 90 jours d’observation comme repère, puis allongez cette période pour les traitements moins fréquents. Remplacez les accès « any-any » par les seules sources, destinations et ports nécessaires.[30][31]
Effectuez une revue complète au moins tous les six mois, et plus souvent pour les accès critiques. Après un changement de déploiement ou d’architecture, testez les flux autorisés et les refus attendus.
Conservez dans le ticket les configurations avant et après le changement, les approbations, l’horodatage et le plan de retour arrière.[30][32]
Le cap reste le même : limiter la propagation et repérer les écarts. Avant chaque mise en production, vérifiez que la cartographie est à jour, que les flux se limitent aux besoins et que les zones ont été testées. Assurez-vous aussi que la surveillance est active, que les accès obsolètes ont été supprimés, que les données sensibles sont isolées et que les environnements sont séparés.[33]
Passez ensuite à un périmètre pilote à faible criticité. Vérifiez ses dépendances : DNS, fournisseur d’identité, bases de données, API, sauvegardes et supervision. Planifiez l’intervention hors des pics d’activité, puis déployez par étapes. Avant chaque changement, lancez des tests réutilisables ; après la mise en production, validez le résultat.[9] N’étendez le périmètre que si les fonctions métier restent disponibles et si les chemins interdits sont bien bloqués. En cas d’échec d’un test, corrigez avant de poursuivre.
Avant l’intervention, préparez une procédure de retour arrière prête à exécuter : sauvegardez la configuration précédente et documentez les étapes à suivre.[9] Après le déploiement, comparez les flux observés aux flux attendus. Mettez ensuite la cartographie à jour à chaque changement d’application ou de dépendance externe, pour que la segmentation suive les flux réels.[34][10]
Le budget dépend de votre architecture, de vos processus critiques et de vos objectifs de reprise (RTO/RPO). Il n’y a donc pas de montant standard.
Commencez par cartographier vos flux, puis estimez le coût total sur 3 à 5 ans : licences ou développement, auxquels s’ajoute la maintenance. Celle-ci représente en moyenne 15 % à 20 % de l’investissement initial par an.
Prévoyez ce budget dès le cadrage du projet, sans oublier les tests et la validation avant la mise en production.
La segmentation réseau classique divise les environnements en zones distinctes pour contrôler les flux et sécuriser leur périmètre. La microsegmentation va plus loin : elle isole les applications ou les services pour mieux protéger les données sensibles et limiter les déplacements d’un attaquant au sein d’un même environnement.
Le choix entre ces deux approches dépend du niveau de contrôle souhaité, du périmètre à protéger, de la criticité des données et de la complexité de vos processus métier.
Traduisez vos objectifs de sécurité en critères mesurables pour chaque zone. Testez régulièrement les flux réels pour vérifier que les accès non autorisés sont bloqués et que les communications nécessaires restent permises. Simulez des intrusions à l’aide de données synthétiques ou anonymisées, puis consignez les résultats.
Pour chaque écart, désignez un responsable, fixez une échéance et prévoyez un nouveau test après correction. Vérifiez aussi que les journaux d’activité et d’accès permettent de retracer les connexions.
Écrit par
Co-fondateur & CEO de Ziema
Je dirige Ziema, où nous concevons les logiciels métier que les éditeurs du marché ne font pas : applications métier, plateformes opérationnelles et SaaS verticaux. Au forfait, avec un périmètre et un délai engagés. Nos références : 24 Heures Le Mans, E.Leclerc, Théra-Connect.
Suivre sur LinkedInOn développe l'application métier calquée sur votre activité, celle qui vous fait gagner le plus de temps. Le code vous appartient.
Une question sur votre projet ?
Décrivez-le en deux lignes, on vous répond sous 24h.
Logiciel métier & ERP·
7 étapes pratiques pour réussir la bascule ERP en PME : périmètre restreint, migrations répétées, tests métier, runbook et hypercare.
12 min de lecture
Budget & méthode·
Règles pratiques pour minimiser, archiver et purger les données selon le RGPD : finalités par champ, durées, logs et droits d'accès.
10 min de lecture
Logiciel métier & ERP·
Conservez vos outils et connectez un flux à la fois pour réduire les doubles saisies, tester et déployer en sécurité.
9 min de lecture